No quiero que me token
“No quiero que me toquen…” canta Charly García en No Toquen. Hace unos días me descubrí cambiándole mentalmente una palabra: no quiero que me token.
No porque tenga algo contra la inteligencia artificial. Al contrario. Me interesa más pensar qué nos está pasando con el lenguaje que discutir si un modelo es mejor que otro.
No quiero que me token
Hay palabras que aparecen sin pedir permiso y, en muy poco tiempo, empiezan a organizar conversaciones enteras. Hace algunos años nadie hablaba de algoritmos. Después llegaron los prompts. Ahora hablamos de tokens.
La palabra circula con una naturalidad bastante extraña. Se compran millones de tokens, se comparan modelos por la cantidad de tokens que admiten, se calculan presupuestos según los tokens consumidos y hasta empezamos a medir una conversación con esa unidad. Todo sucede como si un token fuera algo tan evidente como una palabra o una página.
Pero un token no es una palabra, tampoco una letra, una sílaba ni una oración. Puede ser una palabra completa, una parte de una palabra, un signo de puntuación o una combinación de caracteres. La misma frase puede dividirse de maneras diferentes según el modelo que la procese. No existe una medida universal porque el token no pertenece al idioma, pertenece a la arquitectura de una máquina.
Que las computadoras necesiten hacer eso no tiene nada de raro. Las máquinas siempre necesitaron traducir las cosas a unidades que pudieran procesar. Lo que me cuesta más entender es en qué momento una solución interna de ingeniería salió de ahí para convertirse en una unidad económica con la que empezamos a medir nuestro trabajo, nuestras ideas y hasta nuestras conversaciones.
Nadie compra una novela preguntando cuántos tokens tiene. Ningún escritor sabe cuántos tokens escribió en su último libro y nadie termina una charla con amigos preocupado porque consumió demasiado contexto. Sin embargo, empresas de todo el mundo ya toman decisiones económicas importantes basándose exactamente en esa unidad.
Nunca terminé de entender cómo se supone que uno tiene que pensar en tokens. Abrís un PDF y puede gastar decenas de miles. Le pedís que escriba una respuesta y consume mucho menos. Analiza una planilla, revisa un repositorio o empieza a programar y el número cambia de maneras que para un usuario son prácticamente imposibles de anticipar. Después de usar inteligencia artificial todos los días sigo sin poder mirar una tarea y pensar: esto va a costar aproximadamente tantos tokens. Recién cuando termina aparece el número.
Con los agentes esto se volvió todavía más difícil. Ya no se trata solamente de hacer una pregunta y recibir una respuesta. Uno le pide que arregle un programa y el agente empieza a leer archivos, escribe código, ejecuta una prueba, encuentra un error, vuelve a leer, modifica otra cosa, rompe algo que antes funcionaba, vuelve atrás y prueba de nuevo. Cada una de esas vueltas consume. Nosotros vemos que está trabajando y esperamos que termine.
Y ahí empezó a aparecer una sensación que cada vez se parece más a una timba.
Uno inicia una tarea sin saber realmente cuánto va a gastar ni en qué momento se va a quedar sin saldo o sin cuota. El agente empieza a trabajar y uno lo deja. Después de un rato aparece un error, pero parece que ya encontró cómo resolverlo. Entonces seguís. Lo arregla y rompe otra cosa. Seguís. Ya llevás bastante gastado y cortar en ese momento significa quedarte con un programa que no funciona y con todo lo anterior gastado para nada. Entonces aparece ese pensamiento bastante conocido: pongo un poco más y termino.
Después otro poco porque ahora encontró el error.
Y después otro porque falta muy poco.
No digo que programar con una inteligencia artificial sea apostar en un casino ni que estas empresas hayan diseñado deliberadamente sus productos para producir una adicción. Eso habría que demostrarlo. Pero la experiencia empieza a compartir algunas condiciones bastante incómodas con una aplicación de apuestas: el costo de la próxima jugada no es del todo claro, el resultado tampoco, abandonar cuesta más cuanto más invertiste y siempre existe la sensación de que el próximo intento puede ser el que finalmente resuelva todo.
Hay además algo parecido al costo hundido. Si ya gastaste veinte dólares intentando resolver un problema y todavía no funciona, gastar cinco más empieza a parecer razonable. No porque hayas decidido que esa tarea vale veinticinco dólares, sino porque parar significaría aceptar que los veinte anteriores no sirvieron. Y una vez que pusiste los cinco ocurre exactamente lo mismo con los veinticinco.
A todo esto se sumaron los límites. Diarios, semanales, mensuales, cada cierta cantidad de horas, por modelo, por herramienta, por plan. Uno paga una suscripción mensual pero eso no significa necesariamente que haya comprado un mes de uso. Puede quedarse sin determinado modelo un martes, recuperar una parte de la cuota unas horas después, seguir teniendo acceso a otra función pero no a la que estaba usando o descubrir en medio de un trabajo que alcanzó un límite semanal. Algunas plataformas separan incluso el consumo de sus propios modelos del de modelos externos y ofrecen después continuar mediante consumo adicional.
Hace falta aprender casi tanto sobre el sistema de facturación como sobre la herramienta.
También están los modelos gratuitos. Uno entra porque un modelo aparece como gratis y efectivamente puede usarlo sin pagar, pero después descubre que existe una cuota, una ventana, un límite de velocidad o alguna otra restricción que no necesariamente puede traducir en una cantidad concreta de trabajo. Gratis puede significar que no cuesta dinero cada vez que se usa, pero no que uno sepa cuánto podrá usarlo antes de que deje de estar disponible.
La situación termina siendo bastante absurda: tenemos modelos gratuitos que no sabemos cuánto podremos usar, suscripciones mensuales que pueden agotarse antes de que termine el mes, límites diarios que conviven con límites semanales, modelos que consumen una bolsa y otros que consumen otra, créditos, porcentajes, tokens y ventanas que se reinician después de determinadas horas. Y cuando todo eso se termina, muchas veces aparece una posibilidad muy sencilla: pagar un poco más y seguir.
Hace unos meses circuló una historia que parecía resumir todo esto de una manera casi perfecta. Un empleado de la fintech Slash había usado Claude para hacer un pequeño videojuego llamado Brainrot Shooter y supuestamente había gastado 81.267 dólares en tokens. La propia empresa publicó la historia, el protagonista mostró una captura de su consumo y medios de distintos países la reprodujeron. Era una cifra tan desproporcionada que resultaba perfectamente creíble dentro del mundo de la inteligencia artificial.
Después se supo que era mentira.
El número de la captura había sido modificado y el costo real del juego había sido inferior a doscientos dólares. Lo interesante es que durante semanas casi nadie dudó de los 81.267. La historia funcionó porque todos aceptamos que algo así podía pasar. Ya nos acostumbramos tanto a no entender cuánto cuesta realmente una tarea hecha con inteligencia artificial que ochenta mil dólares por un videojuego absurdo no parecía una cifra imposible sino una buena noticia sobre los peligros del consumo de tokens.
Eso dice bastante más que la anécdota.
La unidad con la que se cobra es extremadamente precisa para quien presta el servicio y bastante mala para quien intenta presupuestarlo. La empresa puede contar hasta el último token que entró y salió. Nosotros podemos saber que nos quedan cientos de miles y seguir sin tener idea de si alcanzan para terminar lo que estamos haciendo.
Y tampoco estamos pagando exactamente por el conocimiento. Cuando un modelo analiza un texto no estamos comprando una determinada cantidad de ideas ni una cantidad determinada de trabajo. Pagamos una infraestructura cuyo costo se expresa a través de una unidad que surge de la forma en que cada sistema fragmenta y procesa el lenguaje. El token tiene una razón técnica, por supuesto, y el procesamiento cuesta dinero. Pero de ahí a convertirlo en una unidad comprensible para una persona hay una distancia enorme.
No es un metro, un litro ni un kilogramo. Tampoco es exactamente una página, una palabra o un minuto. Es una medida que funciona perfectamente dentro de la máquina y que nosotros aprendimos a usar por fuera aunque todavía no sepamos muy bien qué significa en nuestra experiencia cotidiana.
Eso es lo que más me interesa de todo esto. La facilidad con la que las categorías de las máquinas terminan convirtiéndose en categorías nuestras. Primero aparecen escondidas dentro de una tecnología. Después sirven para explicar cómo funciona. Más tarde empiezan a organizar los precios y finalmente terminamos incorporándolas a nuestra manera de hablar.
De golpe dejamos de escribir palabras para producir tokens. Dejamos de leer documentos para consumir contexto. Una conversación puede ser demasiado larga porque “se quedó sin ventana”. Un programa deja de ser difícil o sencillo y empieza a ser caro en inferencia. Una tarea puede no haber terminado pero la cuota sí.
Internet ya había hecho algo parecido. Nos acostumbramos a hablar de algoritmos, interacciones, alcance, impresiones y métricas para describir cosas que antes llamábamos de otra manera. Ahora la inteligencia artificial agrega tokens, contexto, créditos y límites. Palabras que nacieron para que funcionaran las máquinas empiezan a organizar también la relación que nosotros tenemos con ellas.
Lo más gracioso es que después descubrí que la metáfora de la timba ni siquiera era una metáfora. Token significa, entre otras cosas, ficha. La que se metía en una máquina para hacerla funcionar. En Argentina tuvimos nuestra propia palabra: cospel. Cambiaron las máquinas, volvieron las fichas.
Y mientras escribía esta nota me di cuenta de que hasta el título ya existía.
En 1989 Charly García abrió Cómo conseguir chicas con “No Toquen”. Mucho antes de que existieran ChatGPT, Claude o todo este delirio, incluso había grabado un demo de la canción con el nombre “No token (No cospel)”.
Treinta y siete años después alcanza con cambiar una letra.
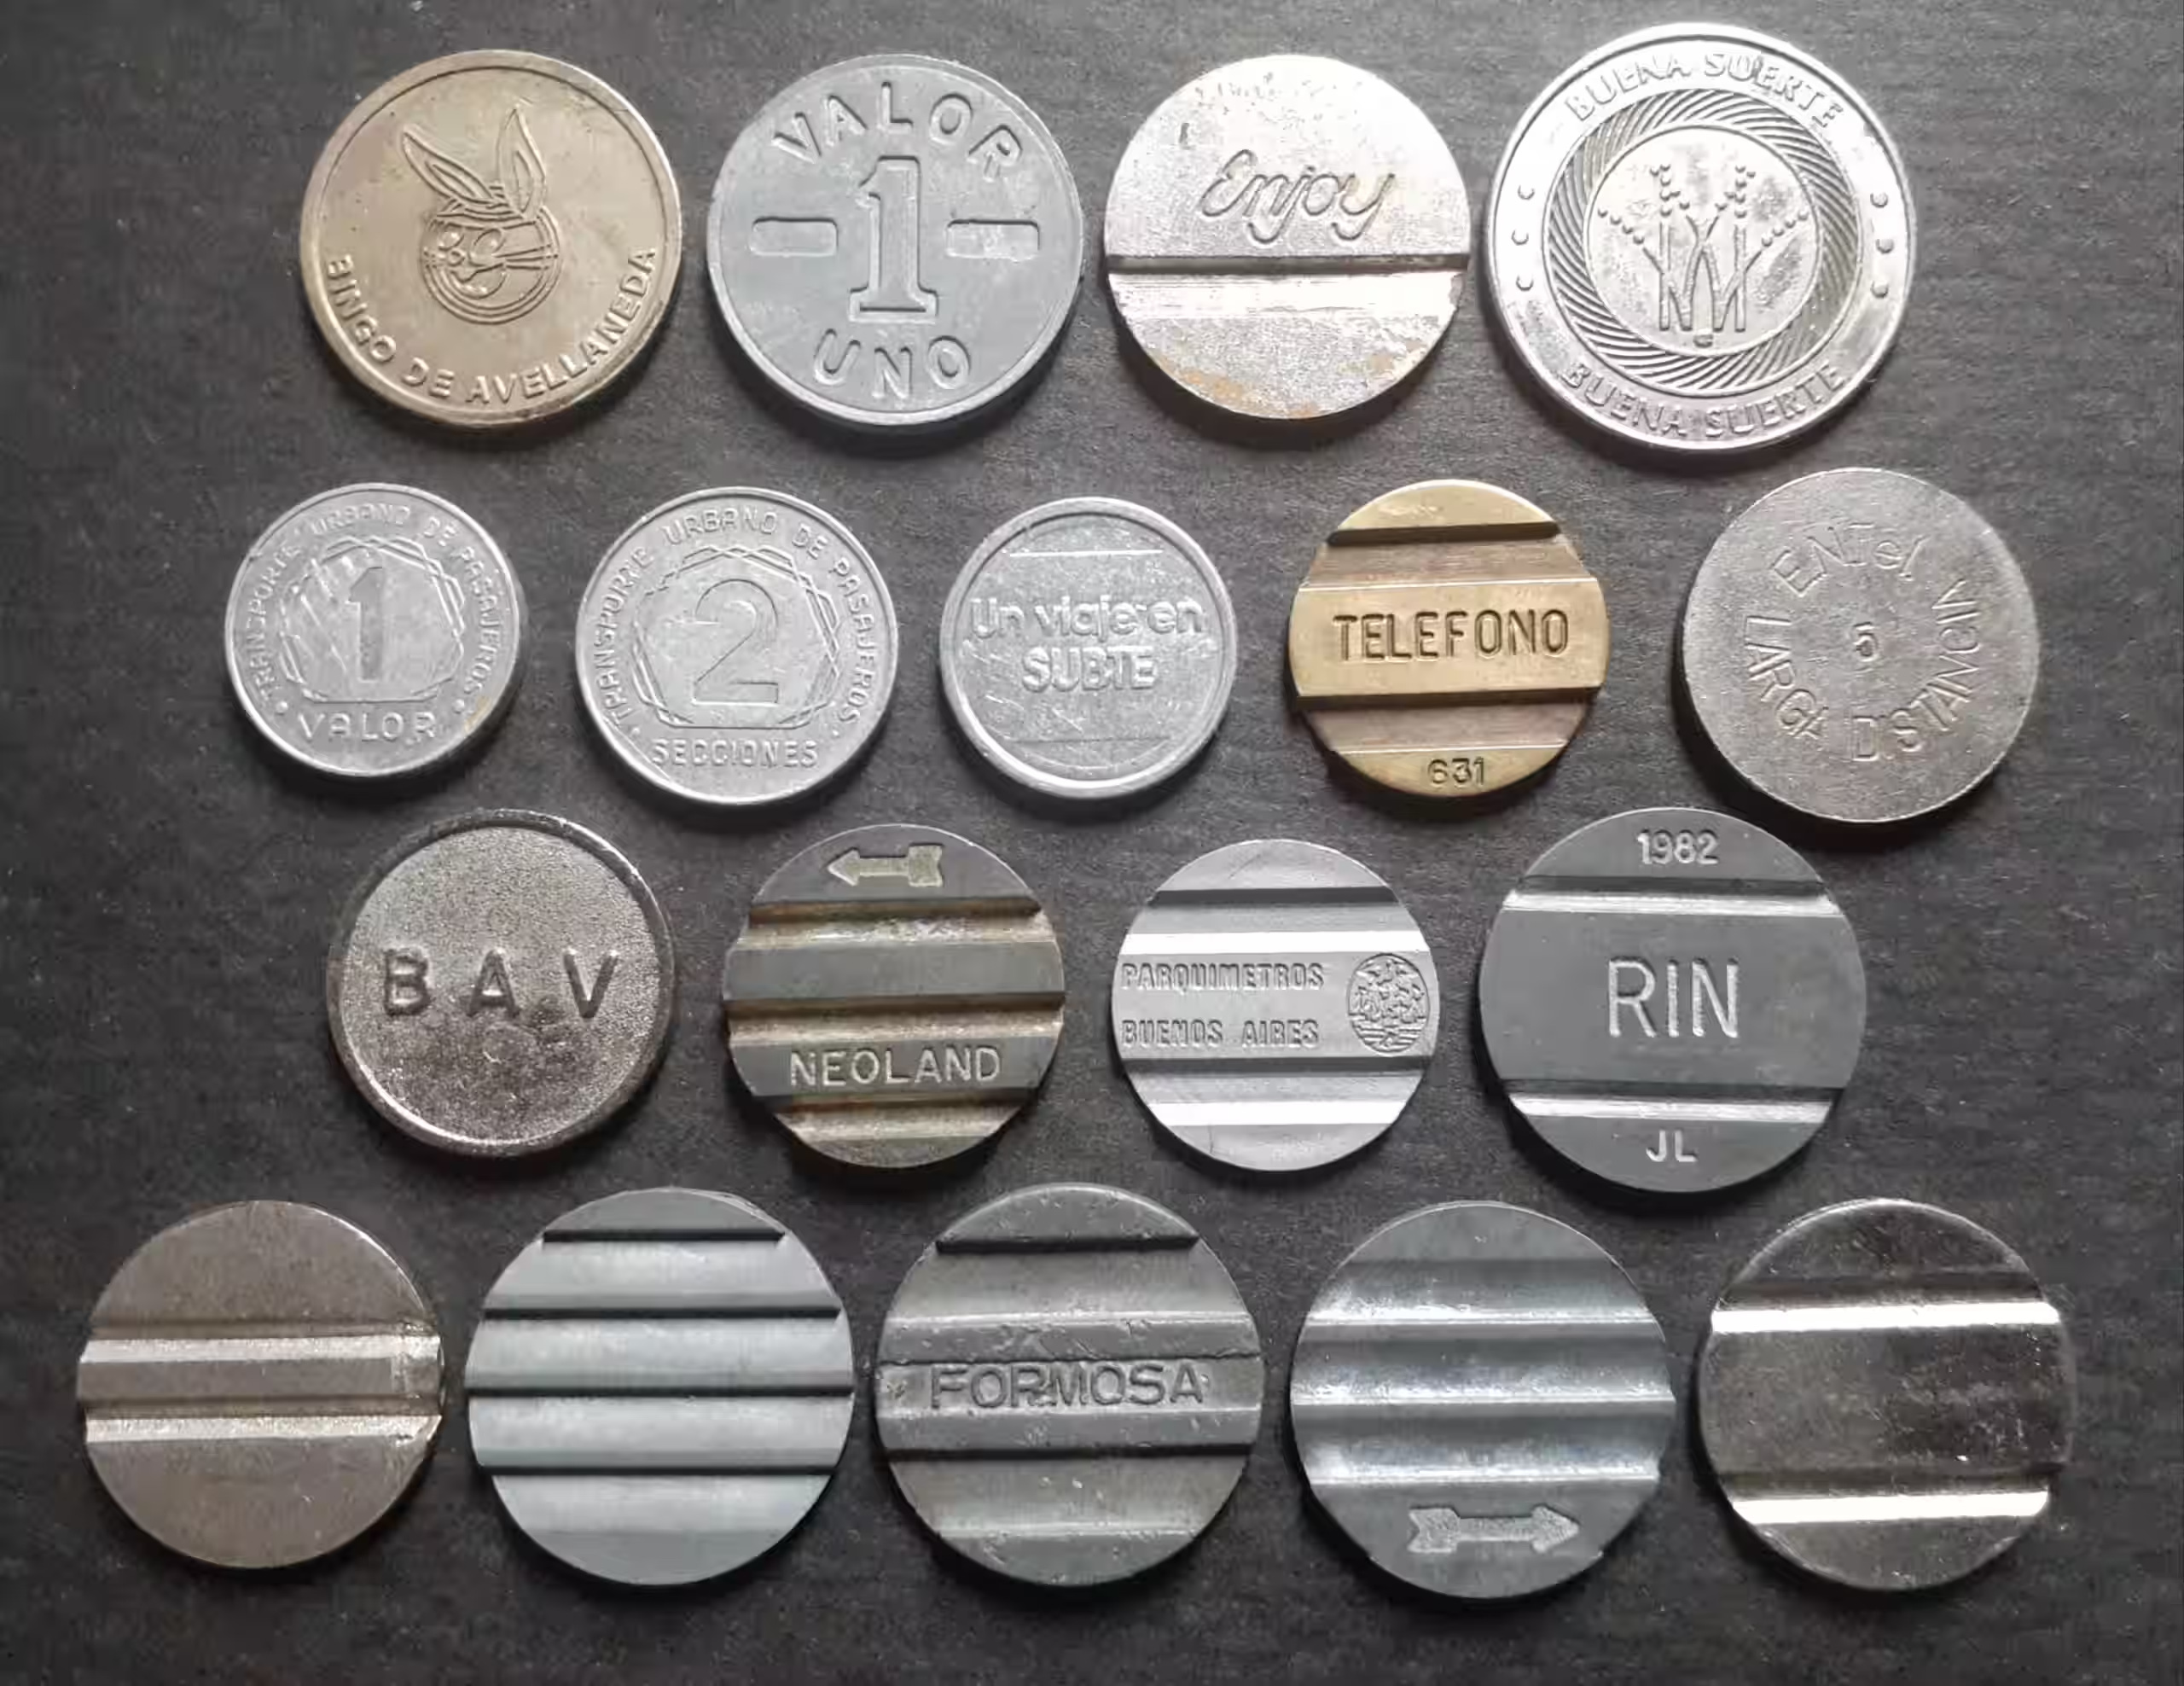
No quiero que me token.

Deja tu comentario